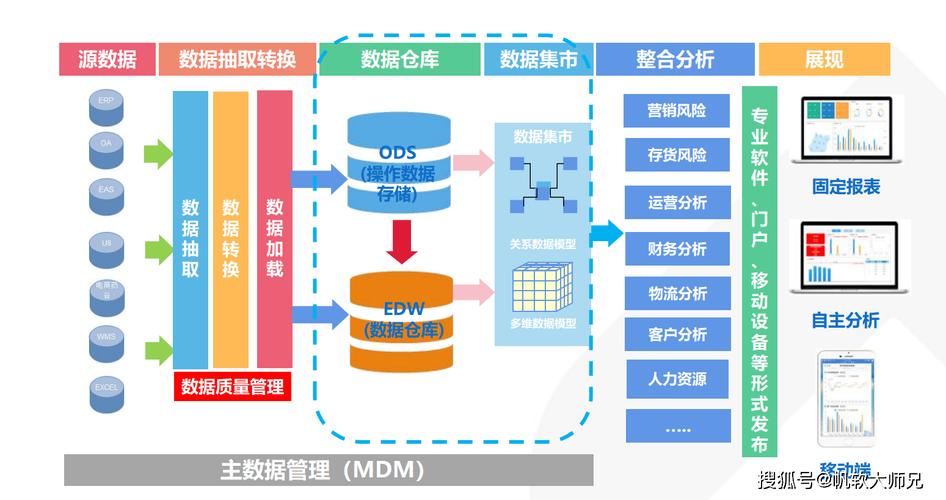
在当今数据驱动的时代,企业每天都会产生海量数据。这些数据来自不同的业务系统、日志、传感器和外部来源,格式各异、质量参差不齐。如果直接使用,不仅效率低下,还容易导致分析结果不一致。因此,一个重要的步骤是:之后,这些数据会被放进数据仓库,统一数据处理和存储服务。
数据仓库作为一个集中式的存储系统,专门设计用于支持查询和分析,而不是日常事务处理。它通过ETL(抽取、转换、加载)或ELT流程,将来自多个源系统的数据整合在一起。所谓“之后”,指的是在数据经过初步清洗、去重、格式转换等预处理后,再进入数据仓库。这一步确保了数据的一致性、完整性和历史可追溯性。
“统一数据处理和存储服务”意味着数据仓库提供了标准化的数据模型(如星型模型或雪花模型)、统一的元数据管理、以及一致的访问接口。无论是业务分析师、数据科学家还是机器学习工程师,都可以基于同一份“事实”进行工作,避免了“同名不同义”或“同义不同名”的混乱。
具体来说,数据仓库的统一服务体现在三个方面:
- 统一存储:所有结构化、半结构化数据集中存放,采用列式存储和压缩技术,降低存储成本,提升查询性能。
- 统一处理:通过调度系统定时执行数据管道,完成数据聚合、连接、衍生指标计算等,确保每个人都使用相同的计算逻辑。
- 统一服务:提供SQL接口、BI工具连接、API服务等,让数据消费变得简单、安全、可控。
因此,当原始数据经过采集和初步加工后,放入数据仓库并接受统一的数据处理和存储服务,就成为了企业数据架构中不可或缺的一步。它不仅是报表和仪表盘的基础,更是数据治理、合规审计和高级分析的前提。只有完成这一步,数据才能真正从“原材料”变成“可信赖的资产”。